Researcher profile
关于
PROFILE / 01
多模态 / 视频模型工程师
让复杂的 AI,成为可靠、自然的产品体验。
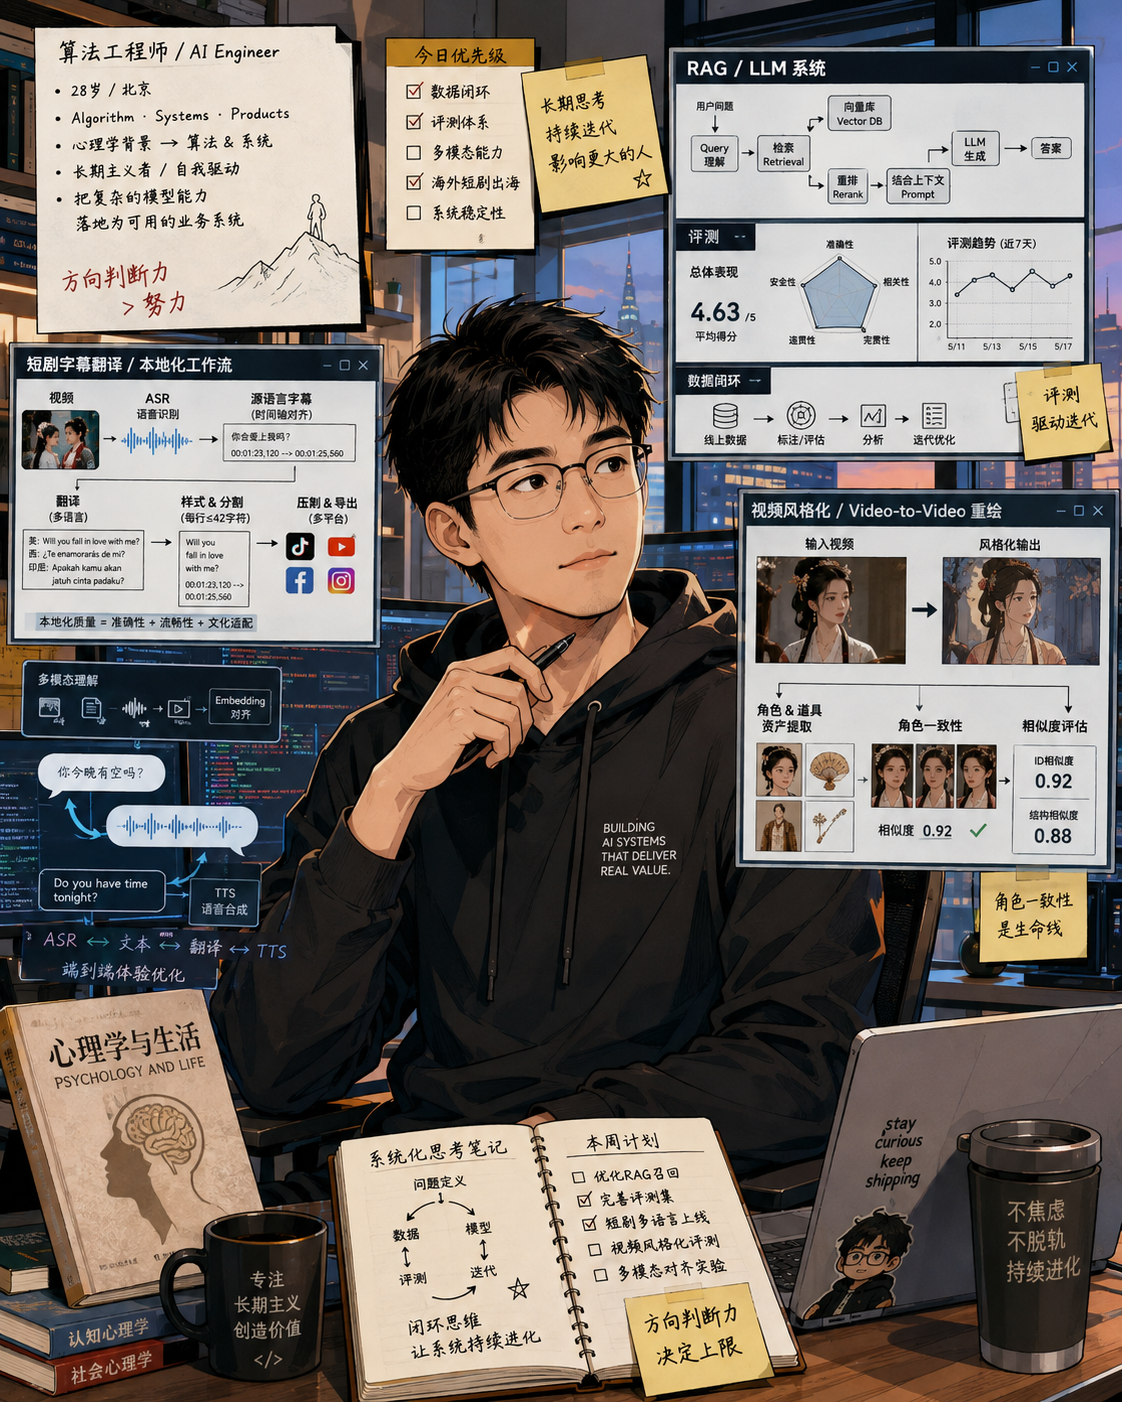
我专注于多模态、视频和 LLM 系统工程。从模型能力、评测数据到服务链路,持续把可行的技术方案推进为可用的业务系统。
MultimodalVideoLLM SystemsModel Engineering
01
方向判断
从真实问题出发,找到值得长期投入的路径。
02
系统落地
让模型、数据与产品在同一套交付链路里协同。
03
持续迭代
用评测和反馈驱动每一次可验证的改进。
正在聚焦
多模态 / 视频模型工程师
多模态与视频
视频理解与生成、文档解析、OCR / DocVQA 与视觉检索。
LLM 与生成质量
RAG / Agent、奖励模型、候选排序、评估与数据闭环。
模型服务与平台
ASR Serving、模型适配、资源管理与可观测性。
职业经历归档
以下内容聚焦可公开的职责、方法与结果;业务名称和实现细节已按保密要求做抽象处理。
- 2026探索中
视频创作 Agent
Agent 工作流设计与开发
探索从创意澄清到分镜视频生成的可控、人机协作式创作工作流。
查看项目 →查看职责摘要
- 拆解创意确认、剧本生成、资产规划与分镜视频生成之间的任务依赖。
- 设计由 Agent 协调的自由创作流程,为后续人工确认和局部重做保留控制点。
- 2026开发中
视频重绘流水线
生成式视频流程开发
将既有视频资产拆解为镜头级的可编辑生产流程,并重建为新的成片。
查看项目 →查看职责摘要
- 设计从视频资产库解析、分镜脚本生成到资产图与分镜视频生成的端到端链路。
- 组织镜头级资产与最终合成之间的中间产物,使流程便于持续调试与迭代。
- 2025持续迭代
多语言翻译质量系统
翻译三阶段 Agent、剧名 RM / RL 与质量闭环建设
围绕剧名与视频字幕翻译,建设从生成、诊断、定向修复到人工反馈和训练数据回流的多语言质量系统。
查看项目 →查看职责摘要
- 在既有字幕初译链路中引入“初译—反思—改进”三阶段 Agent:由反思阶段定位错译、漏译、术语、字幕错位、CPS 和语区表达问题,再由改进阶段只修复问题行。
- 设计剧名多候选生成、硬性质量过滤、LLM 多维度打分和加权选择流程;使用人工偏好与实际采用数据构建奖励模型,并将奖励信号用于 RL 迭代候选生成和排序。
- 建设主动反馈与数据回流流程,关联译员问题、最终人工版本、实际采用剧名、语种、模型和策略版本,将生产反馈整理为评估、训练及回归样本。
- 建立剧名采用率、字幕单行修改率、整集无修改率与严重错误分类等指标,按语种持续比较 Agent、Prompt、规则、RM 和 RL 版本的效果。
- 2025已完成
ASR 性能优化与统一 AI 中台
ASR 服务优化、评测建设与 AI 中台开发
围绕语音识别服务的处理速度与并发能力,完成多进程推理和数据传输优化;收集中英文、四川方言及业务音频,搭建模型接口评测流程,并通过统一 AI 中台承接业务接入。
查看项目 →查看职责摘要
- 负责 ASR 推理服务的加速与并发优化,调整锁粒度、多进程 Worker、共享内存传输和多设备模型调度,并通过压测验证方案。
- 收集中文三个开源数据集、英文三个开源数据集、四川方言数据和实际业务音频,完成人工标注,并搭建调用不同 ASR 模型接口的效果评测程序。
- 建设统一 AI 中台,提供模型与 Agent 接入、知识库检索、API Key 鉴权、业务配置和用量管理,打通异步语音转写与结果回调。
- 2024已完成
行业多模态平台
平台子能力研发
面向复杂行业场景,交付多语种文档解析、语音识别、视觉向量检索与 LLM 文本理解等可复用平台能力。
查看项目 →查看职责摘要
- 整合 PP-OCR、EasyOCR 与 MinerU,构建多语种 OCR 路由、版面还原、结构化抽取与 DocVQA 能力。
- 使用 Whisper large-v3 与 LoRA 完成小语种、行业术语适配,并实现流式分段与端点检测的服务化部署。
- 基于 ResNetV2-50 / CLIP 提取视觉特征并接入 Milvus,支持以图搜图、文字搜图及文档封面等视觉检索场景。
- 探索以 Qwen / GPT 为核心的 Prompt-based 文本分类,支持无标签冷启动场景;完成容器化、灰度发布、监控与异常降级。
- 2023已完成
文化服务智能客服
项目 Owner / 全流程开发
独立负责 ASR、RAG/Agent、LLM 与 TTS 的智能客服闭环,并完成话务接入、模型服务、评测与数据生产工具建设。
查看项目 →查看职责摘要
- 基于 LlamaIndex 与 Milvus 构建知识库检索、工具路由与多轮问答,设计 System Prompt 与 Few-shot 模板,并建立召回率、覆盖率与幻觉率评测。
- 完成 Whisper large-v2 LoRA 领域微调、CTranslate2 INT8 推理优化,以及 ChatGLM LoRA 意图识别和 Qwen 服务部署。
- 使用 3D-Speaker 与 VAD 实现自动分段、多说话人分离、身份核验与黑名单能力;结合 Edge-TTS 和 VITS 支持语音反馈与音色迁移。
- 对接 FreeSWITCH,打通 WebSocket 流式 ASR → RAG/Agent → LLM → TTS 链路;建设链路追踪、回放、ASR/QA 标注与 Prompt 版本管理工具。